Konsistenz und Generalisierung
Vier Hypothesenräume, zwei Datenmengen — Begleitmaterial zu Abbildung 19.1 (Russell & Norvig, Künstliche Intelligenz).
Was Konsistenz bedeutet
Eine Hypothese heißt konsistent mit einer Trainingsmenge , wenn sie jeden einzelnen Trainingspunkt exakt trifft:
Definition
Gleichbedeutend: der Trainingsfehler ist exakt null. Bei quadratischer Verlustfunktion also .
Konsistenz ist eine binäre Ja/Nein-Eigenschaft, keine graduelle Qualitätsaussage. Sie ist außerdem eine Aussage ausschließlich über die bereits gesehenen Daten — über das Verhalten von an einer neuen Stelle sagt sie nichts.
Der Ausdruck stammt aus der logischen Sichtweise des Lernens. Man denkt sich jeden Datenpunkt als eine Beobachtung, die eine Hypothese entweder bestätigt oder ihr widerspricht. Konsistent heißt dann: die Hypothese steht zu keiner Beobachtung im Widerspruch. Im Versionsraum-Lernen (candidate elimination) ist genau die Menge der konsistenten Hypothesen das, was der Algorithmus verwaltet und mit jedem neuen Beispiel weiter einschränkt.
In der Statistik heißt ein Schätzer konsistent, wenn er für in Wahrscheinlichkeit gegen den wahren Parameter konvergiert. Das ist eine asymptotische Aussage über unendlich viele Daten — also praktisch das Gegenteil dessen, was hier gemeint ist. Beide Begriffe heißen gleich und haben nichts miteinander zu tun.
Warum Konsistenz nicht ausreicht
Ob Konsistenz überhaupt erreichbar ist, hängt nicht von den Daten ab, sondern vom gewählten Hypothesenraum . Ist klein (etwa alle Geraden), gibt es meist gar keine konsistente Hypothese. Ist groß genug, gibt es beliebig viele — und dann wird Konsistenz als Auswahlkriterium wertlos, weil sie zwischen ihnen nicht unterscheidet.
Der Schlüsselfall ist das Polynom vom Grad 12. Bei 13 paarweise verschiedenen -Werten ist die zugehörige Vandermonde-Matrix invertierbar, das Gleichungssystem hat also genau eine Lösung. Eine exakt passende Hypothese existiert damit immer — unabhängig davon, wie die Daten aussehen. Konsistenz ist hier geschenkt und deshalb kein Qualitätssignal.
Vier Hypothesenräume im Vergleich
Alle vier Räume werden an dieselben 13 Datenpunkte angepasst. Die zugrunde liegende Funktion ist in beiden Zeilen dieselbe, ; die beiden Datenmengen unterscheiden sich nur durch ein anderes Rauschen .
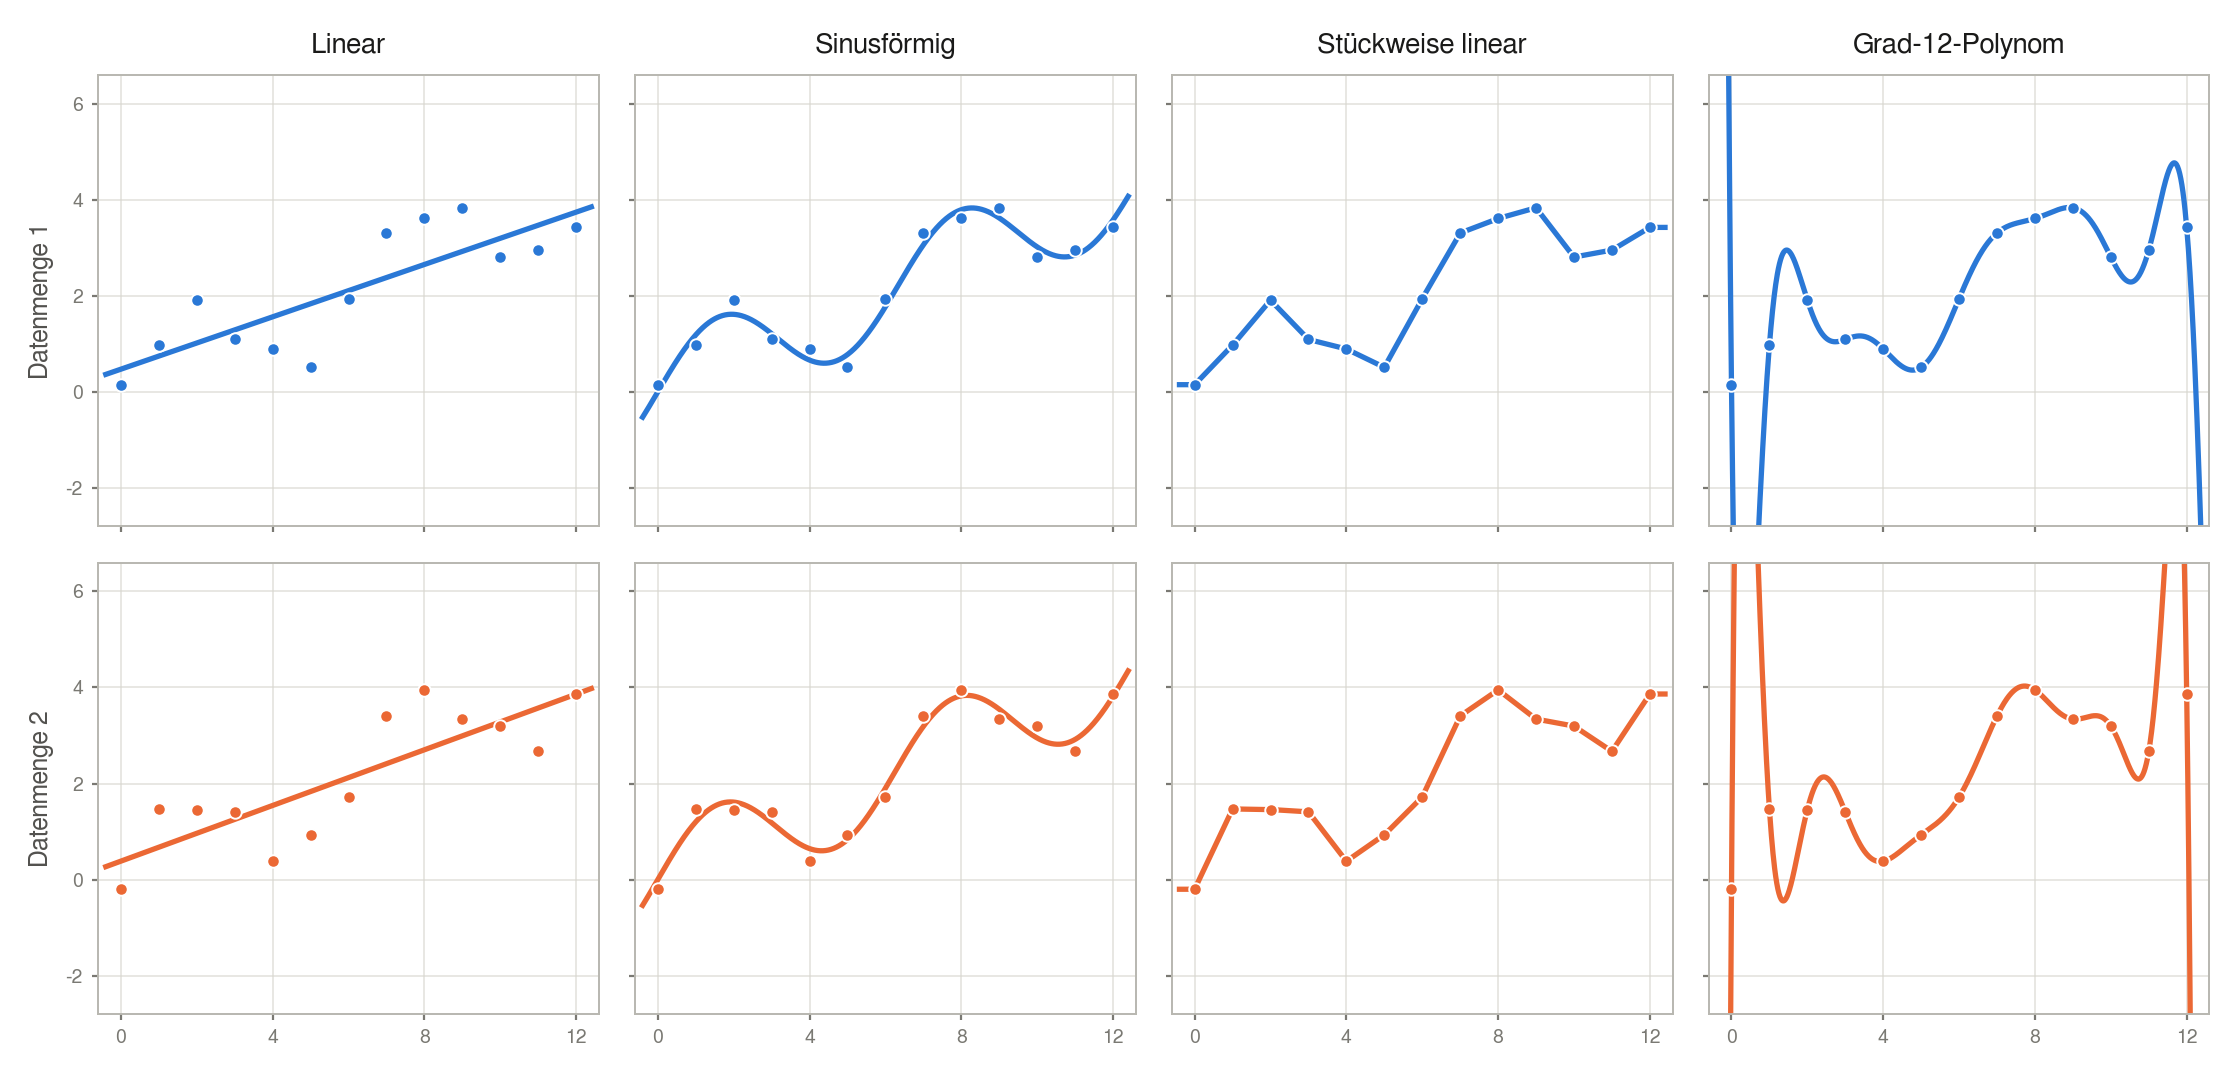
Abbildung 1: Beste Anpassung aus vier Hypothesenräumen. Obere Reihe: Datenmenge 1. Untere Reihe: dieselben vier Räume, angepasst an Datenmenge 2 (gleiche Funktion, anderes Rauschen).
| Hypothesenraum | Form | Freie Parameter | Trainingsfehler | Konsistent? |
|---|---|---|---|---|
| Linear | 2 | 6,70 | nein | |
| Sinusförmig | 2 | 0,54 | nein | |
| Stückweise linear | Polygonzug durch die Punkte | 24 | 0,00 | ja |
| Grad-12-Polynom | 13 | 0,00 | ja |
Tabelle 1: Der Trainingsfehler ist das Mittel der Residuenquadratsummen über beide Datenmengen. Beim stückweise linearen Modell zählen zwei Parameter pro Segment (12 Segmente).
Der eigentliche Test: Stabilität
Konsistenz allein trennt Unter- und Überanpassung nicht — sie sagt nur, ob die linke Seite der Fehlerzerlegung null ist. Aussagekräftiger ist der Vergleich der beiden Anpassungen: Da beide Datenmengen dieselbe Funktion beschreiben, sollte ein gutes Modell zweimal annähernd dasselbe liefern. Der Flächeninhalt zwischen den Kurven ist ein direktes Maß für die Varianz des Verfahrens.
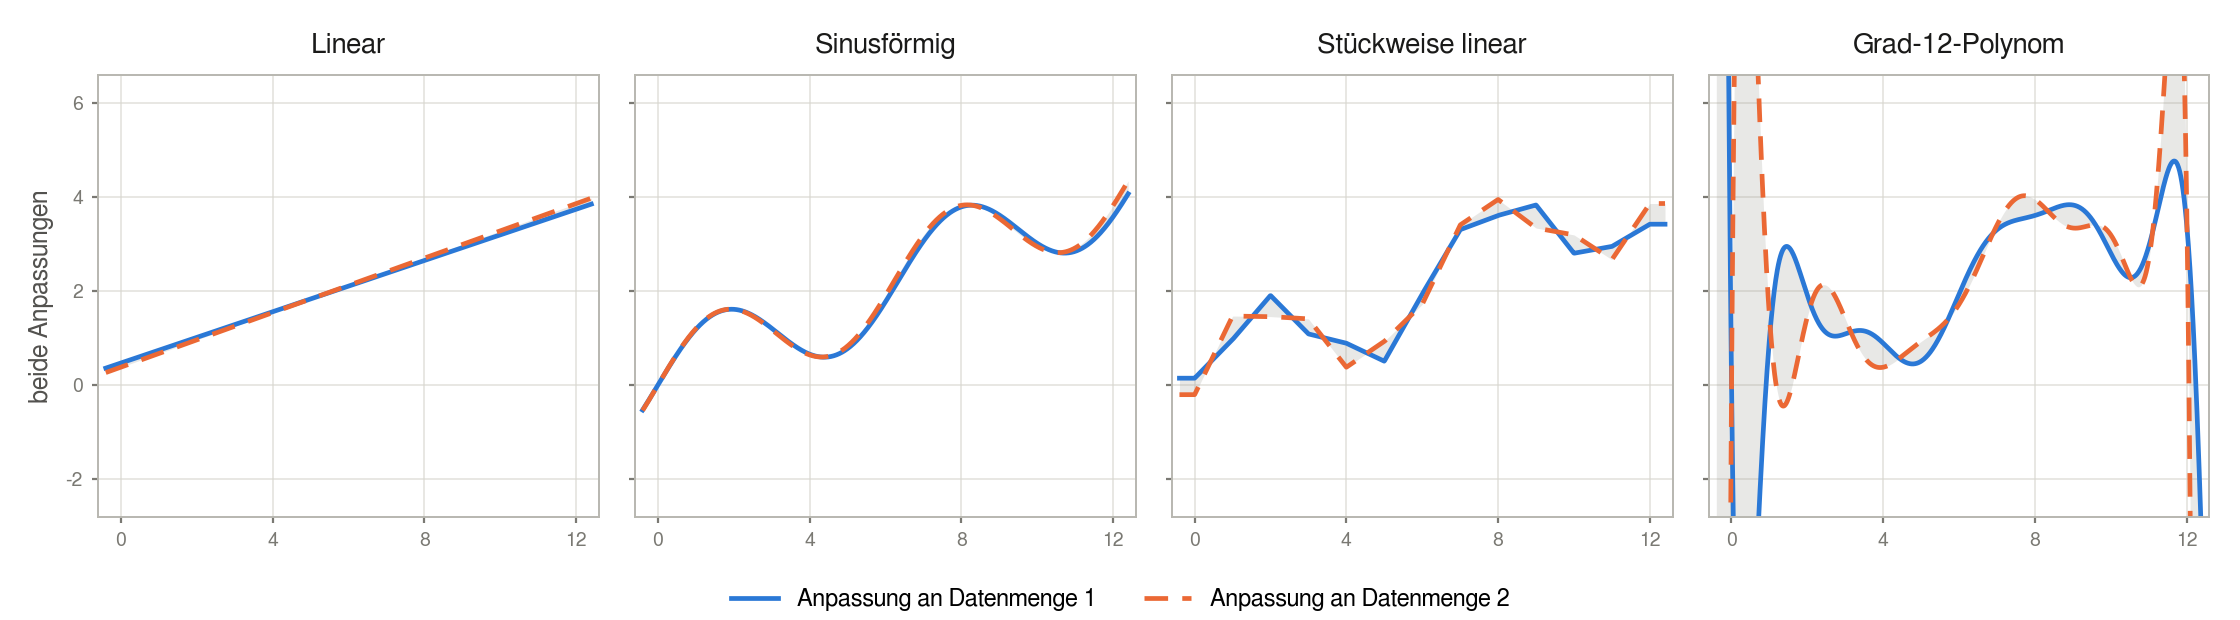
Abbildung 2: Beide Anpassungen übereinandergelegt. Die graue Fläche ist der Unterschied, den allein das Rauschen verursacht — links kaum sichtbar, rechts dominant.
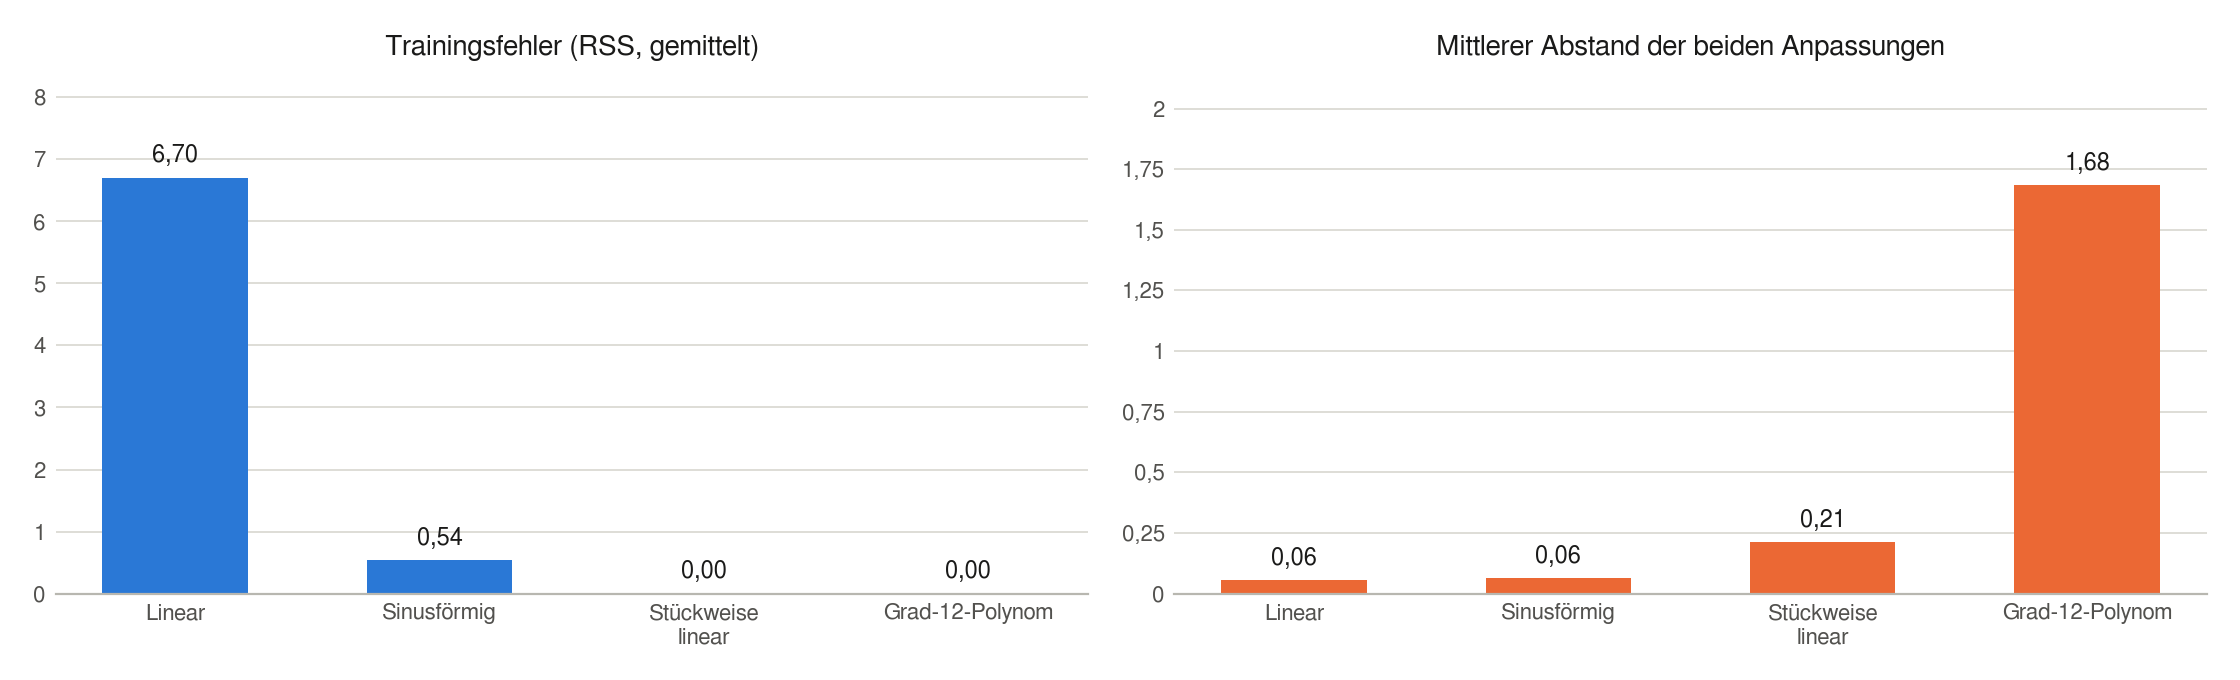
Abbildung 3: Trainingsfehler (links) und mittlerer Kurvenabstand (rechts). Die beiden Extreme liegen an entgegengesetzten Enden: linear hat großen Fehler bei kleinem Abstand, das Polynom Fehler null bei großem Abstand. Der Wert 1,68 ist wegen der Beschneidung am Bildrand noch unterschätzt.
Lesart der vier Spalten
Linear
Zwei Freiheitsgrade reichen nicht aus, um die Krümmung abzubilden. Der Fehler bleibt groß, beide Geraden liegen aber fast aufeinander. Klassische Unteranpassung.
Sinusförmig
Der Raum enthält die Struktur der wahren Funktion. Der Restfehler von 0,54 ist genau das Rauschen, das nicht mitgelernt wird. Formal nicht konsistent — und trotzdem das beste Modell der vier.
Stückweise linear
Konsistent per Konstruktion, weil die Punkte einfach verbunden werden. Das Modell speichert die Daten, statt sie zu komprimieren: 24 Parameter für 13 Punkte erklären nichts. Zwischen den Punkten ist es reine Interpolation.
Grad-12-Polynom
Fehler null, aber die Kurve schwingt an den Rändern wild aus (Runge-Phänomen). Die minimale Änderung der Daten verändert die Hypothese drastisch.
Konsequenzen für die Praxis
Ockhams Rasiermesser
Wenn Konsistenz nicht auswählt, braucht es ein zweites Kriterium. Ockhams Rasiermesser liefert es: unter den hinreichend gut passenden Hypothesen die einfachste wählen. Formal wird daraus die Minimierung von Verlust plus Komplexitätsstrafe:
Regularisierte Zielfunktion
Bei linearen Modellen ist der zweite Term etwa (Ridge) oder (Lasso). Der Parameter steuert genau den Kompromiss, den die vier Spalten aufspannen.
Bei verrauschten Daten ist Konsistenz schädlich
Das Rauschen wird mitgelernt
Gilt mit Rauschen , dann bedeutet für alle , dass die Hypothese das Rauschen mitlernen muss — sie hat gar keine andere Wahl. Ein exakter Fit ist unter Rauschen also nicht das Ziel, sondern das Symptom.
Der Begriff Konsistenz gehört streng genommen in die idealisierte Welt deterministischer Zielfunktionen; im verrauschten Fall ersetzt man ihn durch „minimiert eine regularisierte Verlustfunktion”.
Merksätze
Vier Sätze zum Mitnehmen
Konsistent = Trainingsfehler exakt null, nichts weiter.
Konsistenz ist eine Eigenschaft des Paars (Hypothese, Trainingsmenge) — nie eine Aussage über neue Daten.
Ein hinreichend großer Hypothesenraum macht Konsistenz garantiert erreichbar und damit als Kriterium wertlos.
Der Vergleich zweier Anpassungen an ähnliche Daten misst Varianz und sagt mehr über Generalisierung aus als der Trainingsfehler.
Quellen: Russell & Norvig, Künstliche Intelligenz — Ein moderner Ansatz, Kapitel 19 (Abbildung 19.1). — Deisenroth, Faisal & Ong, Mathematics for Machine Learning, Cambridge University Press 2020, Kapitel 8 (mml-book.com). Die Abbildungen sind eigene Nachrechnungen mit der Funktion 0,35x + sin(x) und additivem Rauschen, nicht die Originalgrafiken.